🔥 今日主线
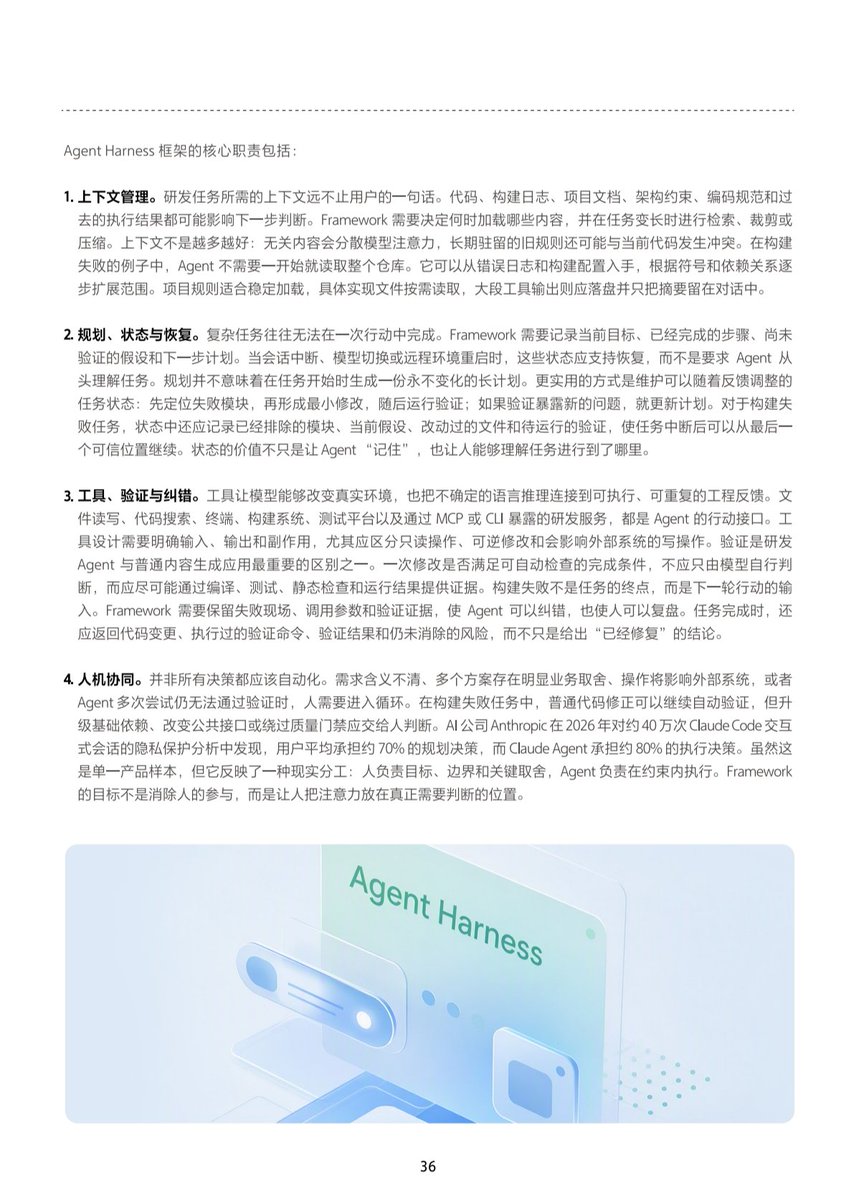
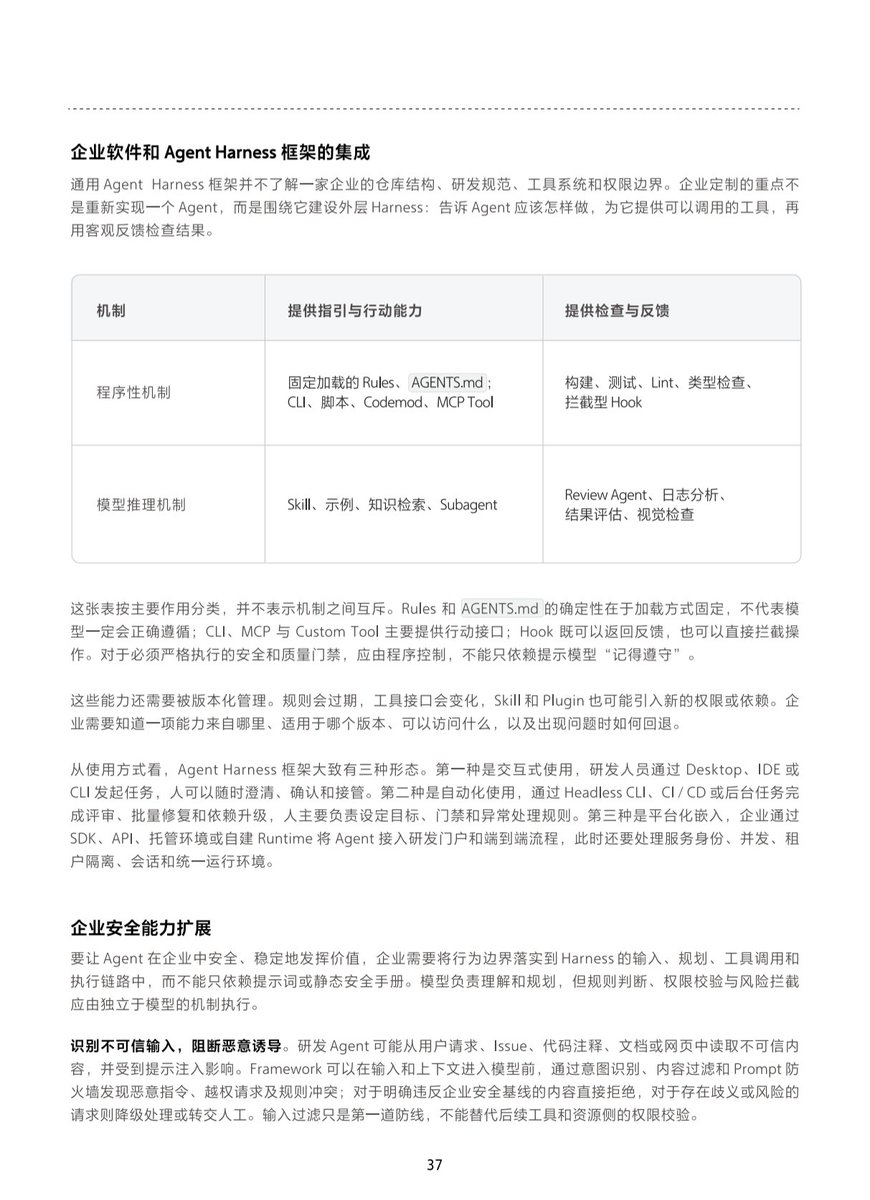
今天的主线从“会生成内容”进一步转向“会做判断、会长期执行、能被验证”:Cloudflare 把多模态决策模型开源,Pi 与 Open SWE 把 Agent Harness 推向可靠的工程基础设施,BootLoops 则把可复现实验和验收门引入科研自动化。另一条明显支线是实时人机交互与音视频创作,Griffin 和 Suno Speech 都在把 AI 从文字界面带到面对面的表达场景。
今天的主线从“会生成内容”进一步转向“会做判断、会长期执行、能被验证”:Cloudflare 把多模态决策模型开源,Pi 与 Open SWE 把 Agent Harness 推向可靠的工程基础设施,BootLoops 则把可复现实验和验收门引入科研自动化。另一条明显支线是实时人机交互与音视频创作,Griffin 和 Suno Speech 都在把 AI 从文字界面带到面对面的表达场景。
Cloudflare 开源的多模态决策模型,把文本、JSON、图片或视频状态映射为带概率的结构化选项,适合做 Agent 路由、分类、升级和人工转交判断。
先打开 Hugging Face 模型卡看输入 schema 和示例,再用 Workers AI 的 Clef API 做一个最小路由器:输入一条客服工单或一段 Agent 状态,定义“正常处理/升级人工/调用检索/拒绝执行”等有限选项,要求模型返回每个选项的概率,不让它生成自由文本。若想本地试验,可按模型卡准备 Transformers、Pillow 和一张支持 CUDA 的显卡,先跑文本或 JSON 分类,再加图片输入。把 Clef 的结果记录到日志,与原来用通用 LLM 的路由结果、延迟和费用做 A/B 对比;图片请求当前不适合直接放在强实时用户链路中。
它把 Agent 中大量“下一步该做什么”的开放式推理,拆成可约束、可审计、可复用的决策层。Clef 支持视觉输入、64K 上下文并兼容 Jev API,输出概率而不是一段需要解析的自然语言。Cloudflare 官方称其在自有评测中优于部分通用模型,但这些成绩仍主要是厂商报告,接入生产前应建立自己的误判、延迟和人工兜底指标。
一个面向 AI Agent 的开源能力层和安装器,把 X、GitHub、YouTube、Reddit、B站、RSS 及任意网页读取能力接到同一套工作流中。
先执行 `pip install agent-reach`,再运行 `agent-reach install` 和 `agent-reach doctor --json`,让它检查 Node、gh、mcporter、各平台 CLI 和当前后端。网页、RSS、公开 GitHub 等零配置渠道可以直接用;需要登录态的平台按 doctor 给出的后端单独配置。最适合先做一个小任务:让 Agent 读取一条 X 推文,再跟进 GitHub README 或官网,最后输出带来源的中文摘要。确认链路可用后,再把它接入日报、竞品监控或研究笔记流程;不要把搜索结果当成最终事实,仍要回到官方页面核验关键结论。
它解决的不是“又一个搜索框”,而是 Agent 如何按渠道选工具、检查依赖并在上游工具变化时切换后端的问题。项目强调零 API 费用、直接调用上游 CLI 和可诊断的能力路由,覆盖面很适合研究型 Agent。登录平台仍需要 Cookie 或账号配置,且不同渠道的稳定性、权限和抓取边界不同,因此生产使用应保留来源 URL、失败原因和人工复核环节。
Pi 是一个极简、可扩展的开源 Agent 工具包和编程 Agent,Pi 1.0 将其从快速迭代项目推进到更强调稳定性、扩展点和长期可依赖性的版本。
先按 Pi 官方文档安装 coding-agent 包,在一个有 Git 的小型项目中启动会话,先只给它文件读取、编辑和测试这类最小工具,再逐步安装扩展。把模型提供商、权限规则、撤销/重做和项目级规则明确写入配置,不要一开始就给全盘 shell 权限。可以复现一项真实小任务,例如让 Pi 修改一个测试、运行测试并提交 diff;随后再试一个扩展或子 Agent,比较默认能力和扩展后的 token、耗时、改动范围。若你不习惯终端,可再尝试 Paseo 这类图形界面,但仍要保留 Git diff 和测试作为验收依据。
Pi 的价值不在功能清单最多,而在把 Agent 的循环、模型接口、TUI、编码工具和扩展机制拆开,让开发者能理解并重组自己的 Harness。它更接近“可编程的 Agent 底座”,适合需要接入私有模型、定制审批或构建多 Agent 编排的人。社区对 Pi 与其他 Harness 的性能比较仍依赖具体模型和任务,不能把单组测试直接当成普遍结论。

Open SWE 是一个 MIT 开源的异步编码 Agent 框架,能从 GitHub、Slack、Linear 或控制台接收任务,在隔离环境中规划、修改、测试并提交工程结果。
https://github.com/langchain-ai/open-swe ↗
https://blog.langchain.com/open-swe-an-open-source-framework-for-internal-coding-agents/ ↗
先阅读仓库 README 和部署文档,准备一个测试仓库、模型 API key、隔离执行环境以及 GitHub 权限;不要直接对生产仓库开放写权限。可以从一个带明确验收条件的 Issue 开始,例如补一个小功能并新增测试,让 Open SWE 生成分支和 PR,再由人工检查 diff、测试日志和权限范围。随后在自己的任务队列中比较短任务和长任务的耗时,观察状态持久化、人工 review、失败重试和重复触发行为。若要接入团队流程,先只允许创建 PR,不允许自动合并,并把 sandbox、webhook、密钥和网络出口单独隔离。
它代表编码 Agent 从一次性聊天工具转向长时运行的软件自动化系统,重点不只是模型能力,还包括状态、沙箱、路由、审查和可恢复性。官方仓库显示项目采用 MIT 许可并持续维护,架构上适合团队围绕 Issue、Slack 或 Linear 组织任务。真正的成本和可靠性仍取决于模型、执行环境、任务拆解与人工审批,不能把“能开 PR”误解为可以无人值守合并。

BootLoops 是面向精确、可验证定量科学的开源 Agent Harness,把数学、物理和其他学科工具统一到共同框架,并要求测试与验收门跟随研究流程。
先从项目站点的 Harness 页面和一个示例工具开始,不要直接把它当成“自动发表论文”的按钮。选一个输入、输出和验证标准都清楚的小问题,把工具、协议、计划和结果放入版本控制;让 Agent 先复现一个已知结果,再运行独立的数值或符号检查,最后保存脚本、参数和误差。只有当结果能由另一段程序在不同精度或不同输入下重算,才把它升级为新的实验线索。使用其他模型时也要明确记录模型、提示、依赖、算力和人工修改,尤其要区分项目作者的研究报告与已经由外部同行验证的结论。
BootLoops 把“Agent 会写代码”进一步变成“Agent 的科学工作可以被验收”。统一工具索引、跨学科复用、测试、接受标准和高精度数值核验,正好针对科研中最难自动化的可重复性问题。项目与 Anthropic 的文章有关,但官方站点明确它不是 Anthropic 项目,且已有结果主要是作者报告,适合作为方法和工作流样板,不应直接视为已确证的新科学发现。
inclusionAI 的开源图像模型可以把一张扁平设计图按层计划拆成独立可编辑的 RGBA PNG,方便继续改字、换色、移动元素和重新合成。
先在 Hugging Face 模型卡下载示例和 companion repository,准备 Python 环境、依赖、输入图片以及层级描述文件。最小实验可以直接复现官方六层卡片示例:克隆仓库、安装 requirements,运行 `python infer.py --task layer-decompose`,指定输入图、prompt、1024 分辨率和输出目录。之后把自己的海报或信息卡写成明确的层计划,先要求 4 到 6 层,检查每层是否为透明 PNG、文字边缘是否完整、重新合成后与原图差异多大。它需要较强 GPU 和模型依赖,普通 Mac 用户更适合先用 Hugging Face Demo 或低分辨率验证流程。
传统文生图或图像编辑往往每次重生成都会影响其他区域,而分层输出把设计重新变成可编辑素材,能把“改一个元素”从整图重绘变成局部资产编辑。模型卡提供明确的层数、RGBA、prompt 和复合示例,工程上比只看展示图更容易验证。不过分层质量、文字保真度和复杂遮挡仍要逐张检查,不能假设所有图片都能无损拆解。


Snapok 是一个原生 macOS 截图应用,支持截图历史、标注、背景与边距美化、敏感信息隐藏、OCR、保留布局翻译以及向 AI 提问。
在 macOS 14 或更高版本上下载官方开发版 DMG,拖入 Applications 后按 README 配置屏幕录制、辅助功能等权限;这是 dev 预览版,重要工作不要只依赖它保存。截取一块网页或终端区域,先试自动隐藏敏感信息,再用 OCR 复制文字、标注重点和调整背景边距;接着测试“保留布局翻译”和对截图提问,检查敏感信息是否真的被遮住、OCR 是否误读以及翻译是否改变了版式。若要从源码构建,按 Swift 6 / Xcode 项目说明操作,并把截图库保存位置、更新机制和 AGPL-3.0 许可纳入评估。
它把截图从一次性图片变成可检索、可解释、可继续编辑的工作对象,尤其适合开发、产品和客服场景。仓库是原生 Swift/AppKit,提供 Apple Silicon 与 Intel 的通用包,并把 OCR、翻译、AI 问答放进同一条捕获流程。需要注意的是仓库当前以 dev 分支为主,许可证是 AGPL-3.0,企业分发或闭源集成前必须先确认许可与商业授权边界。

Suno Speech 把语音表达和原创背景音乐合成在同一条音轨中,可用文字、诗或故事描述声音风格、语气和音乐氛围。
登录 Suno 网页或移动端,进入创作入口选择 Speech,先粘贴一段 30 到 60 秒的中文或英文短稿,再描述声音的年龄、语气、节奏和背景音乐风格。先关闭音乐生成,检查发音、停顿和情绪是否可接受;再打开背景音乐,让它分别生成安静旁白、播客片头、睡前故事或产品介绍。把同一文案用不同语气重复测试,比较音乐是否压住人声、专名是否读错、停顿是否过度戏剧化。它处于公开 Beta,发布前应人工听完并确认版权、声音拟真和商业使用条款。
这不是简单的 TTS 加一条背景音乐,而是把 spoken audio 与音乐作为一个创作结果联合生成,降低了非音乐用户制作有氛围旁白的门槛。官方已向所有用户开放 Beta,同时也明确提醒口音和戏剧停顿仍可能不稳定。它更像快速创意和草稿工具,若用于广告、课程或品牌内容,仍需人工剪辑、事实审校和版权检查。

Tavus 发布 Griffin,提出 Human Interaction Model 概念,用全双工视频到视频系统进行实时面对面交流。
Griffin 的重点不是把一个语言模型接到头像上,而是同时处理用户的语音、表情、停顿和对话时机,并在同一条实时链路里生成回应。Tavus 官方称其在一项一分钟视频通话研究中让 48% 的参与者以为对面是真人,但 Griffin-Lite 目前仍只是面向少量测试者的研究预览,官网也明确说 Griffin 尚未进入 Tavus 平台。这个结果更适合作为交互范式和评测方式的信号,而不是成熟产品能力的保证。
如果实时视频交互继续降低延迟,客服、销售、培训、陪练和远程服务会从“问答窗口”转向更像面对面的协作。但拟真度越高,身份披露、录音录像同意、未成年人保护和诈骗防范越重要;企业采购时应同时审查延迟、可控性、审计记录和用户是否能清楚知道自己面对的是 AI。

X List 转述一项与 Krisp 合作的 Voice Isolation 基准讨论,指出当用户和其他人同时说话时,系统需要先判断哪段语音属于用户。
当单人、安静环境下的语音转写已经足够好,继续堆 STT 的平均准确率未必能解决真实通话中的失败。双人同时说话时,两路信号都是真实语音,系统要处理说话人识别、打断、回声、轮次和用户意图归属;这会直接影响语音 Agent 是继续执行、暂停确认还是误把旁人的话当成指令。本条来自 X List 的讨论线索,本次外部证据 enrichment 超时,具体基准数据和实现细节应继续核验。
语音产品的评测指标会从 WER 扩展到竞争说话人场景、误触发率、打断恢复时间和高风险指令的确认率。做语音 Agent 时,前端麦克风阵列、VAD、speaker diarization、回声消除和“只接受主用户”的策略,可能比更换一个普通 STT 模型更值得优先投入。

X List 分享一篇由 Hinton、Bengio 等研究者参与讨论的论文,关注 AI 自动化 AI 研发是否可能加速能力增长。
这条线索的核心不是“AI 已经能独立做完整研究”,而是把研究流程拆成文献检索、假设生成、代码实现、实验运行、评估和复盘,再由人或另一个系统充当验证者。若这些环节能稳定串联,模型改进本身就可能获得更高的实验迭代速度;但研究目标选择、数据污染、评测泄漏和结果解释仍是硬问题。本条目前以 X List 推文为主要来源,论文原文与作者信息需要进一步核对,暂不把“智能爆炸”当成已证实结论。
研究组织可能更重视实验基础设施、可重复评测和模型对模型的审查,而不只是招聘更多手工调参人员。对企业而言,真正的护城河会转向高质量私有数据、可回滚实验管线、独立验证集和能追踪每个结论来源的研究记录;对个人开发者,则意味着先学会设计评测和验收门,再追求让 Agent 自动运行更多步骤。