🛠️ Agent Skills:把 AI 编程推进到 Define→Plan→Build→Verify→Review→Ship
一句话
Addy Osmani 的开源 Agent Skills 把需求澄清、计划、实现、测试、代码评审和发布拆成可复用的工程技能,让 Claude Code、Codex、Cursor 等编程 Agent 不只是“写完代码”,而是按阶段交付并验证。
怎么玩
先在有 Node.js 的开发环境中执行 `npx skills add addyosmani/agent-skills`,也可以先用 `--list` 浏览技能,再只安装需要的单项技能。安装后在一个小型项目里依次尝试 `/spec` 明确目标、`/plan` 拆分任务、`/build` 实现、`/test` 验证、`/review` 检查质量,最后用 `/ship` 做上线准备。建议先拿一个 30 分钟能完成的习惯追踪器或 CLI 小功能试跑,不要一上来把整个生产仓库交给自动流程;每个阶段都保留规格、测试输出和评审意见,才能看出它是否真的减少返工。
为什么值得关注
它的重点不是又一个提示词模板,而是把资深工程师的质量门槛编码成可重复工作流。对 Vibe Coding 来说,最稀缺的并非首版代码,而是边界条件、测试、审查和发布纪律;这套流程把“做得快”和“交付可控”放在同一条链上,也适合作为团队 Agent 的默认操作规范。
应用场景
- 给个人项目增加需求澄清、自动测试和合并前审查,减少 Demo 与可用软件之间的落差。
- 为团队统一 Claude Code、Codex、Cursor 等不同 Agent 的工程流程,沉淀可审计的交付记录。
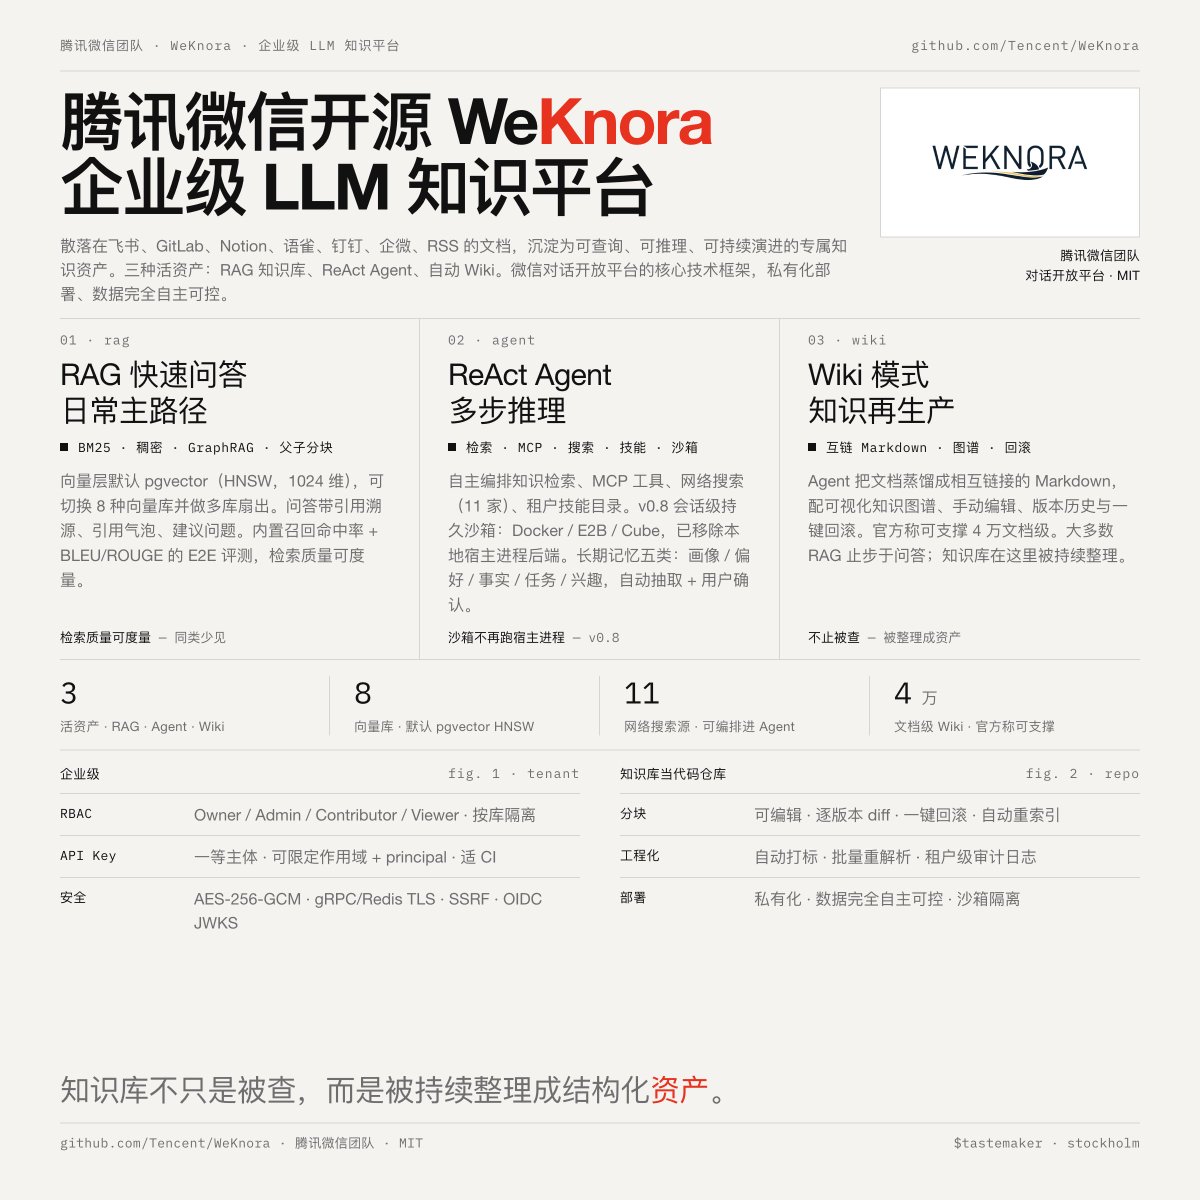
🛠️ WeKnora:把企业文档变成 RAG、ReAct Agent 和可演进 Wiki
一句话
腾讯 WeKnora 是开源 LLM 知识平台,可把原始文档加工成可问答的 RAG 知识库、能调用检索与工具的 ReAct Agent,以及持续生成和维护的互联 Wiki。
怎么玩
准备 Docker、Docker Compose 和 Git,先克隆官方仓库,阅读 `.env.example` 与 README,配置模型、向量/重排服务和登录信息,再按仓库提供的 Compose 入口启动服务。进入界面后先上传一组自己熟悉的 PDF、Markdown 或技术文档,分别测试普通知识库问答、Agent 模式和 Wiki 模式;重点检查答案引用、检索片段、生成页面之间是否能回到原文。若要接入外部工具,再从 MCP 配置开始,先用只读工具验证权限和审计日志,再逐步开放写操作。
为什么值得关注
很多 RAG 产品停留在“把文档塞进向量库然后聊天”,WeKnora 把知识库、推理 Agent、MCP 工具、技能目录和自动 Wiki 放进同一平台,目标是让原始资料形成可持续维护的知识资产。对企业而言,Wiki 的版本、引用和人工修改能力比一次性回答更重要;对开发者而言,Docker 化和多模型后端也降低了本地试验门槛。
应用场景
- 把产品手册、内部制度和技术文档做成带引用的企业问答与故障排查入口。
- 将长期积累的项目资料整理为可编辑、可追踪版本的团队 Wiki,并让 Agent 参与更新。
🛠️ OpenDesign:让本地编码 Agent 直接产出网页、幻灯片和视觉原型
一句话
OpenDesign 是本地优先的开源 AI 设计工作区,把 Claude Code、Codex、Cursor、OpenCode 等编码 Agent 接入可组合技能和 DESIGN.md 设计系统,输出真实的 HTML、PDF、PPTX、MP4 等文件。
怎么玩
先从 GitHub README 或官网安装桌面/本地版本,准备一个空项目和自己常用的编码 Agent,再按照 README 的适配方式连接运行时;需要 MCP 集成时可参考 `od mcp install claude`、`od mcp install codex` 等官方命令。第一次不要追求完整品牌站,直接输入一个具体任务,例如“用苹果风格玻璃拟态做一个三页产品介绍页”,让 Agent 生成初稿;然后用同一套 DESIGN.md 约束颜色、字体、间距,再要求它输出 HTML 和 PDF,对照源码与渲染结果检查是否可编辑、资源是否落在本地以及是否出现未经授权的品牌素材。
为什么值得关注
它把设计从“在画布上手工摆像素”改成“用 Agent 生成可交付文件”,同时保留源码、字体、组件和设计系统,避免只得到一张不可维护的图片。BYOK 和本地优先路线也意味着模型可以替换,设计规则可以进入版本控制;真正的价值在于让原型、网页、演示文稿和视频共享同一套可复用的视觉约束。
应用场景
- 用自然语言快速做产品落地页、仪表盘、交互原型,再把真实 HTML 交给开发继续维护。
- 为小团队建立可版本化的品牌设计系统,批量生成网页、演示文稿和短视频素材。
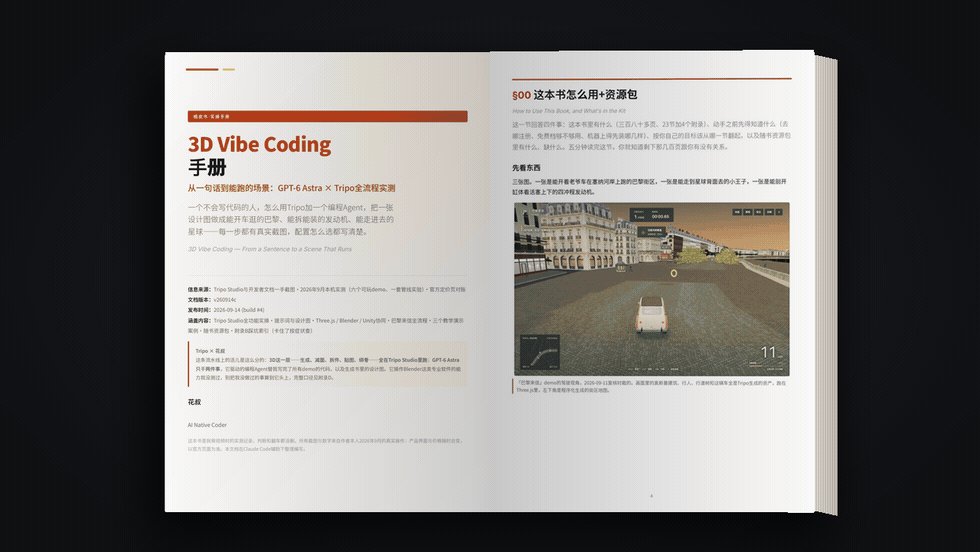
🛠️ Hyper3D Rodin + BlenderMCP:从文字或图片进入可编辑的 3D 场景
一句话
Hyper3D Rodin 提供文字/图片生成 3D 资产,BlenderMCP 把 Blender 场景控制、模型生成和部分自动化操作暴露给 AI Agent,组合后可以从描述快速得到可继续编辑的模型或场景。
怎么玩
先安装 Blender 和 `uv`,再按 BlenderMCP 官方 README 配置插件与 MCP 服务;Claude Code 用户可从仓库示例开始,用 `claude mcp add blender uvx blender-mcp` 注册服务。然后在 Hyper3D/Rodin 准备试用额度或 API Key,在 Blender 中打开一个空场景,先让 Agent 创建一个低复杂度道具,再要求它检查场景、调整材质和导出格式。可复现实验是“生成一个可打印的小物件”:保留原始提示词、生成任务状态和 STL/GLB 文件,手动在 Blender 检查网格、尺寸和法线,不要把一次视觉上好看的结果直接当成生产资产。
为什么值得关注
这条路线的变化不只是“AI 会做 3D”,而是把生成资产、场景编排、截图检查和导出串成可调用的工具链。官方集成同时覆盖传统 Blender 操作、Poly Haven 素材和 Rodin 生成,适合把一次性生成推进到可编辑场景;但生成模型的拓扑、尺寸和版权仍需人工复核,不能只看演示视频下结论。
应用场景
- 为科普网页、游戏原型和产品展示快速生成可编辑的道具与场景。
- 以图片或文字先做 3D 打样,再交给设计师修正拓扑、材质和打印参数。
🛠️ Atria Dawn Preview:面向长流程、可验证结果的 Agent 模型
一句话
Atria Dawn Preview 是上海人工智能实验室发布的 Agent 模型预览版,官方定位覆盖科研自动化、复杂工程任务、工具使用和多步交付,并提供在线试用、Hugging Face/ModelScope 模型入口。
怎么玩
先访问官方站点查看 Discovery、Creation、Delivery 等演示,再用官方在线入口或 API 做一个边界清楚的任务,例如读取几份资料、提出实验方案、生成一个小型交互页面并列出验证步骤。希望本地运行时,先在 Hugging Face 页面确认模型下载、FP8 版本、许可证和硬件要求,不要根据宣传语自行估计机器能否承载。测试时把任务拆成“输入资料—工具动作—生成文件—验证结果”四段,保存中间产物,并检查它是否真的完成了可复现交付,而不是只输出一段看似完整的说明。
为什么值得关注
当前很多模型发布只强调排行榜,Atria 的公开叙事更强调从问题探索、方案设计到执行和验证的闭环;官方资料也明确将其放在长时程 Agent、科研自动化和生产力任务中。它是否能稳定处理真实环境、失败恢复和证据链仍需大量实测,因此今天适合把它当作可试验的新路线,而不是已经验证的生产替代品。
应用场景
- 对比不同模型在资料检索、工具调用和结果验证组成的长任务上的实际完成率。
- 用科研自动化、交互原型或办公流程做小规模基准,观察失败后能否修正并留下证据。
🛠️ Mole:一个命令行覆盖清理、卸载、分析和监控的 macOS 工具
一句话
Mole 是 tw93 开源的 macOS CLI,可清理缓存和残留、卸载应用、分析磁盘,并提供系统资源监控;独立的 Mole for Mac 还提供原生 GUI。
怎么玩
在 macOS 终端先执行 `brew install mole`,然后用 `mo --version` 确认安装。第一次务必从 `mo clean --dry-run`、`mo uninstall --dry-run` 或 `mo optimize --dry-run` 开始,只查看将要处理的路径;确认没有把工作项目、微信资料或开发缓存误判后,再选择具体动作。需要找大目录时先做分析,再决定是否清理;如果使用独立 GUI,则从官网下载安装并对照 CLI 结果。清理系统文件前建议关闭相关应用、保留备份,并把“释放了多少空间”与“哪些路径被处理”记录下来。
为什么值得关注
对开发者来说,磁盘问题往往来自构建产物、包管理器缓存、日志和卸载残留,图形清理软件不一定能解释每一步。Mole 把清理、卸载、磁盘洞察和实时监控收进一个免费开源 CLI,适合脚本化和复盘;同时官方将 GUI 独立定价,使用者可以按“终端可审计”或“原生可视化”选择,而不必混淆两种产品。
应用场景
- 在 Mac 开发机上先预览再清理构建缓存、安装包和卸载应用残留。
- 用命令行或脚本定期排查磁盘、CPU、内存和网络占用,定位异常目录。
📡 OpenAI 将 Codex for Open Source 计划名额从 5,000 提升到 10,000
事件
X List 转述 OpenAI 第二轮 Codex for Open Source 计划扩容,面向开源维护者提供 Codex、API 额度及相关支持,以减轻 PR 审查、Issue 分类、发布和安全维护负担;OpenAI 官方页面确认该计划面向活跃开源项目维护者申请。
解读
这不是单纯的免费额度促销,而是模型厂商争取进入开源项目日常维护环节。维护者真正需要的是理解大型代码库、审查补丁、处理重复 Issue、生成发布流程和发现安全问题,Codex 若能嵌入这些流程,模型就从“开发者个人助手”变成“软件供应链基础设施的一部分”。但名额增加不等于维护工作自动化已经可靠,使用者仍要确认权限边界、代码和私密 Issue 的数据处理方式,以及 AI 建议是否经过人工 review;对小项目,低风险的文档、测试和分类任务更适合作为起点。
影响评估
开源维护者获得更多试用和 API 资源,可能加速 AI 进入代码评审、发布自动化和安全修复;模型厂商则能获得大量真实工程反馈。长期看,项目的贡献指南、测试覆盖、审计日志和权限控制会比“能不能生成代码”更影响采用结果,也会推动开源项目把维护流程进一步结构化。
📡 语音智能体评估从一个总分拆成“执行、结果、体验”三条线
事件
X List 分享 LangChain 对语音 Agent 评估的总结:分别检查是否按规范执行、是否解决用户目标,以及通话是否自然流畅;LangChain 官方文章进一步建议同时追踪录音、转写、模型、工具和 TTS 等完整链路。
解读
语音 Agent 的失败经常被一个“满意度分数”掩盖:它可能说话很自然,却没有完成预约;也可能正确调用了工具,却因为延迟、打断处理或尴尬停顿让用户中途挂断。把执行、结果、体验分开,才能定位是提示词、工具编排、业务系统还是 ASR/TTS 造成的问题。对工程团队来说,评估对象不应只有最终文本,还要保留一次交互的 trace、工具调用和音频证据,并用代表性真实通话持续回归,而不是只在离线脚本上测几条理想样本。
影响评估
客服、外呼、预约和销售等语音场景会更容易建立可量化的上线门槛,模型替换也可以比较延迟、成功率和体验之间的取舍。与此同时,录音和转写带来隐私与合规要求,企业需要在采样、脱敏、留存和人工复核之间建立制度;“自然”不能替代业务完成,“完成”也不能掩盖用户体验恶化。